「ChatGPTにうちの会社名を聞いても出てこない。競合は出てくるのに」。最近多いご相談です。先に言うと、最初に確かめるのは記事の中身ではなく、自社サイトがChatGPTの検索用ボットを受け入れているかです。ここが閉じていれば、検索回答には出ません。
この記事は「ChatGPTに自社サイトを引用してもらうには何をすればいいですか?」に、サイトの設定とブランド情報の整備で答える手順書です。記事1本の組み立て方はChatGPT検索で引用される記事の書き方、Googleも含めた全体像は生成AI検索対応SEO 実践ガイドに分けています。仕様は2026年10月31日時点のOpenAI・Google公式ページで確認した内容だけです。
先に期待値をそろえます。OpenAIは引用元の選定基準を公開していません。Googleも「Indexing and serving aren’t guaranteed.」(インデックスと表示は保証されない)と書いています。約束できるのは引用ではなく、拾われる条件を自社側で満たすことです。
私は前職で17年間、自社ECの事業運営に関わり、最終的に執行役員を務めました。広告費ゼロ・自然検索のみで年商1〜2億円を集客し、主要キーワードでは約10年間1位を維持しています(2位は日本の時価総額1位企業の公式サイト、3位はAmazon)。現在は神戸・芦屋でSEOコンサル「雅〜WEB〜」を運営しています(支援実績:miyabi-web.jp/production/)。
※本記事には広告(アフィリエイト)リンクは含まれません。記事内でご案内しているのは、私のSEOコンサル(自社サービス)への無料相談のみです。
この記事でわかる4つのこと
- 検索用と学習用ボットの違いとrobots.txtでの分け方
- インデックス・ブランド情報・一次情報の整え方
- GA4での流入計測と月1回の定点観測
- 引用を保証する施策はない理由と、避けたい3つのこと
前職で検索1位を守れたのは、土台を毎月点検する地味な作業をやめなかったからです。AI検索でも同じだと考えています。保証できないことは保証しない。やったかどうかが分かる作業から片づける。
ChatGPT引用の結論|まず「検索用ボットを許可しているか」で決まる
OpenAIの公式ページにはこうあります。「Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers」(OAI-SearchBotを拒否しているサイトは、ChatGPTの検索回答に表示されない)。
つまり入口は、サイト側の1つの設定です。LLMO(大規模言語モデル最適化=AIの回答に自社の情報が正しく使われるようにする取り組み)の全体像はLLMO対策 完全ガイドにまとめていますが、この記事では入口から順に、7つの作業に絞ります。
7つとも、「やったかどうか」を自社で確認できる作業です。逆に「引用されるかどうか」はOpenAIの判断で、外からは動かせません。
- OAI-SearchBotを拒否すると、検索回答に出ない(OpenAI公式)
- 入口はサイト側の設定。記事の中身より先に確認する
- 7つの作業は、すべて自社で確認できる
ChatGPTの仕組み|検索用と学習用は別のボット
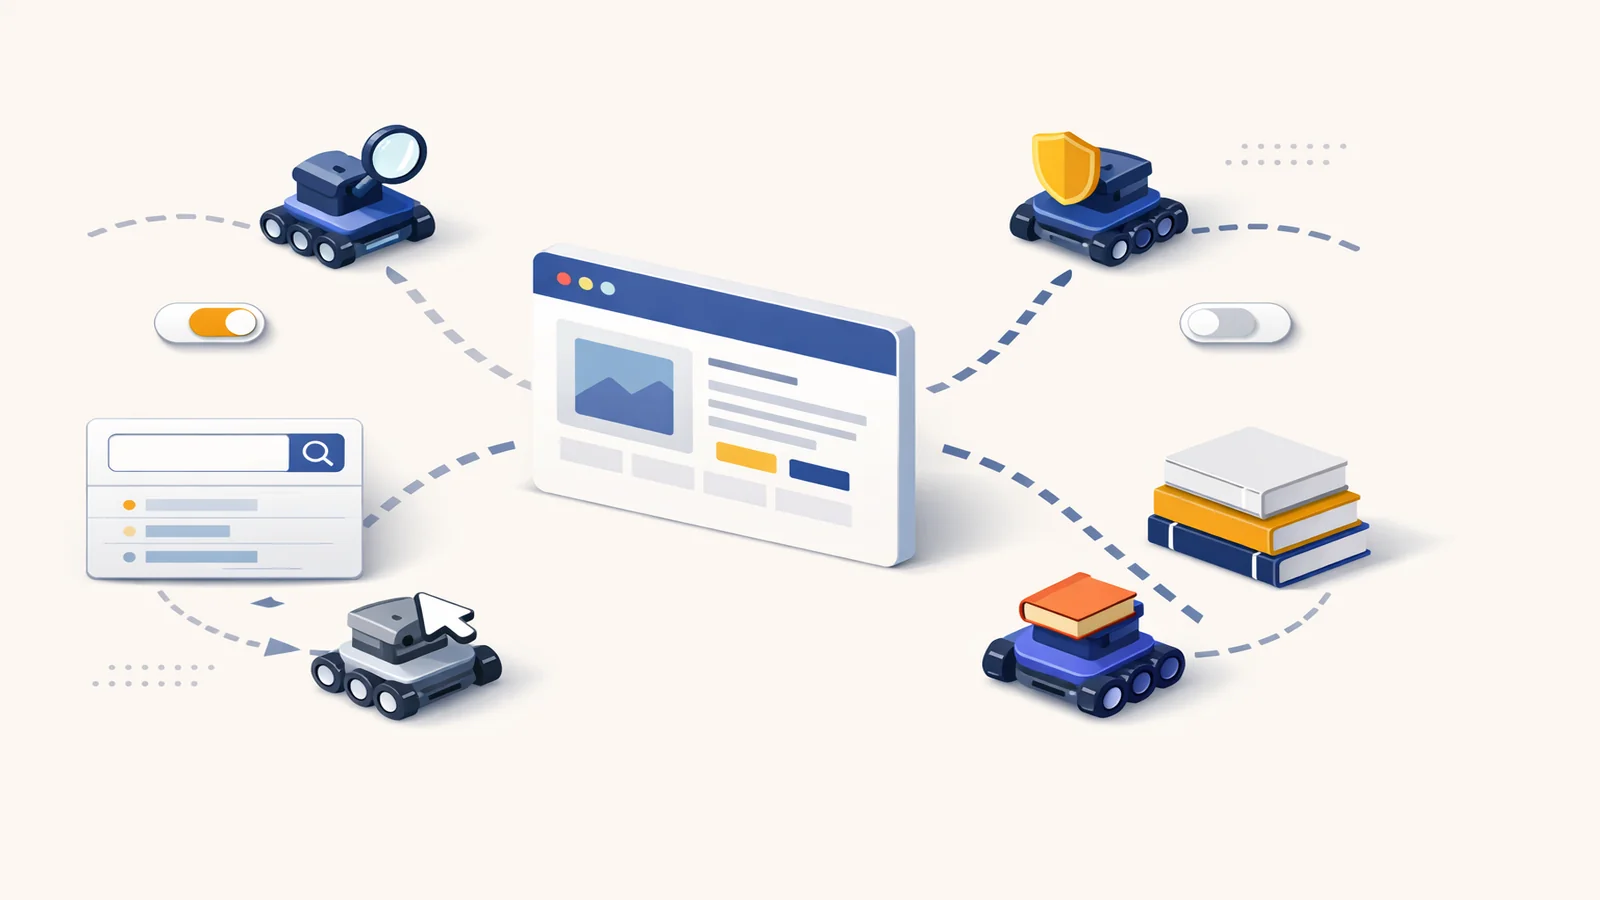
ChatGPTのボット(クローラー=サイトを自動で巡回して情報を集めるプログラム)は、目的ごとに分かれています。OpenAIの公式ページ「Overview of OpenAI crawlers」(2026年10月31日取得)の4種類です。
| ボット名 | 役割 | robots.txtで止められるか |
|---|---|---|
| OAI-SearchBot | ChatGPTの検索でサイトを表示するための巡回 | 止められる(止めると検索回答に出ない) |
| GPTBot | 生成AIの基盤モデルの学習に使われ得る情報の巡回 | 止められる(学習に使わない意思表示) |
| ChatGPT-User | ユーザーの依頼でページを見に行くアクセス | ルールが適用されない場合がある |
| OAI-AdsBot | ChatGPT広告に申請されたLP(ランディングページ=広告から最初に開くページ)の安全確認 | 記載なし(申請ページのみ訪問) |
押さえるべきは「検索」と「学習」が別の設定だということ
公式ページには、各ボットの設定は独立していて、GPTBot(学習用)だけを拒否し、OAI-SearchBot(検索用)は許可することができると書かれています。「学習されたくないから全部止めた」で、検索の入口まで閉じるのがもったいない失敗です。
なお、OAI-SearchBotを拒否していても、公式ページには「can still appear as navigational links」(ナビゲーション的なリンクとしては表示される場合がある)とあります。
分からないことは「分からない」と置いておく
OpenAIのPublishers and developers FAQ(2026年10月25日取得)にも、引用元を選ぶ基準の記述は見当たりませんでした。基準を断定する情報は、出典がOpenAI自身かを確かめてください。記事1本の中身の整え方はChatGPT検索で引用される記事の書き方で扱っています。
- OpenAIのボットは4種類。検索はOAI-SearchBot、学習はGPTBot
- 学習だけ断り、検索は受け入れる設定ができる
- 引用元の選定基準は非公開。断定する情報は出典を確かめる
ChatGPT引用のステップ1-2|robots.txtでOAI-SearchBotを許可する
robots.txt(ロボッツ・テキスト=検索ボットに「どこを巡回してよいか」を伝える、サイトの入口に置くファイル)は、ブラウザで https://自社ドメイン/robots.txt を開けば誰でも見られます。
ステップ1:今のrobots.txtを開いて、3点だけ見る
- 「OAI-SearchBot」の下が「Disallow: /」になっていないか。なっていれば検索回答に出ません
- 「User-agent: *」の下に「Disallow: /」がないか。全ボットへの全面拒否です
- 「GPTBot」の扱い。学習を断るかは検索と別に決めます
私が実際に確認した2サイトの結果(2026年10月31日)
当サイト(develop-life.com)と雅〜WEB〜(miyabi-web.jp)のrobots.txtを開いて確認しました。どちらも「User-agent: *」に対して管理画面(/wp-admin/)だけを拒否する内容で、OAI-SearchBotもGPTBotも拒否していない扱いでした。
OAI-SearchBotと同じ名乗り(UA=ユーザーエージェント、アクセス元が名乗るボットなどの名前)でのアクセスも、正常に表示されました(応答コード200)。ただし私の手元からの確認で、OpenAIのIPアドレスからのアクセスを再現したものではありません。
ステップ2:検索と学習の扱いを決めて書く
全面拒否がなければ、何も足さなくても拒否していない扱いです。学習だけ断るなら次のように書きます。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /上の例は「検索用は許可、学習用は拒否」です。OpenAIは、検索に表示させるにはOAI-SearchBotと、公開しているIPアドレス範囲からのアクセスを許可することを推奨しています。IPアドレスの一覧は https://openai.com/searchbot.json で公開されていて、更新されることがあります。
作業前に守ってほしい2つの注意
- 変更前に今のrobots.txtを丸ごと保存する。1行の誤りでGoogleまで止まることがあります
- robots.txt以外の場所で弾かれていないか確かめる。サーバー会社のWAF(ウェブアプリケーションファイアウォール=不正なアクセスを自動で遮断する仕組み)や、セキュリティ系のプラグインの設定で、ボットが弾かれている場合があります
公式ページによると、robots.txtを変えてから検索側に反映されるまで約24時間かかります。アクセス記録を見られるなら、数日後にOAI-SearchBotの訪問も確かめます。
- robots.txtは「OAI-SearchBot」「User-agent: *」「GPTBot」の3点を見る
- 変更前にバックアップ。WAFやプラグインでの遮断も疑う
- 反映まで約24時間(OpenAI公式)
ChatGPT引用のステップ3|インデックスとスニペットの可否を確認する
入口を開けても、ページ側で「載せないで」と指示していれば出ません。見るのはインデックス(検索エンジンの索引への登録)とスニペット(検索結果に出る抜粋文)を許可しているかどうかです。
OpenAIとGoogle、それぞれの公式の条件
| 確認先 | 公式に書かれている条件 |
|---|---|
| ChatGPT(OpenAI) | 要約やスニペットに含まれるには、OAI-SearchBotをブロックしていないことが必要。完全に出したくないページはnoindexのタグを使うが、そのタグを読むためにボットがページに到達できる必要がある |
| Google検索の生成AI機能 | ページがインデックスされ、スニペット付きで表示される資格があること。それでも表示は保証されない |
確認する3つの場所
- ページのnoindex(検索結果に載せないでという指示):WordPressの「表示設定」で「検索エンジンがサイトをインデックスしないようにする」に印がないか。プラグインでページ単位に設定していないか
- スニペットを止める指示:ページに「nosnippet」などの指定がないか
- GSC(Google Search Console=検索結果での順位や流入を確認できる無料ツール)のURL検査:主要ページが「登録済み」になっているか
当サイトの記事ページでは、指定は「max-image-preview:large」(画像を大きく表示してよい)だけで、noindexはありませんでした。未登録のページが多いなら、検索順位が上がらない15の原因から先に点検します。
注意点として、robots.txtで拒否したページは、noindexのタグ自体が読まれません。両方設定すると、かえってタイトルとリンクだけ出ることがあります。
- robots.txtの次は、ページ側のnoindexとスニペットの指定を見る
- Googleは「インデックス+スニペット可」が条件。保証はない
- robots.txtで拒否すると、noindexのタグは読まれない
ChatGPT引用のステップ4|会社・ブランド情報を1か所に揃える
次は中身の食い違いです。会社名・住所・料金・実績の数字がページごとに違うと、AI以前に人が読んでも「どれが本当か」で迷います。
揃える項目と、よくあるズレ
| 項目 | 基準にするページ | よくあるズレ |
|---|---|---|
| 会社名・屋号・ブランド名 | 会社概要 | 正式名称と略称、カタカナと英字が混在 |
| 住所・電話・営業時間 | 会社概要・アクセス | 移転前の住所や、古い営業時間がフッターに残る |
| 料金・送料・返品条件 | 料金ページ・ご利用ガイド | 値上げ後もブログ記事に旧料金が残る |
| 実績の数字 | 実績ページ | トップと実績ページで件数や年数が違う |
進め方は「基準ページを決めて、他を合わせる」
- 項目ごとに基準にするページを1つ決める(会社概要・料金・実績など)
- サイト内を項目名で検索し、基準と違う記載をすべて書き出す
- 古い記載は直すか、基準ページへのリンクに置き換える(私の経験則として、数字の直書きが多いサイトほど更新のたびにズレが増えます)
Google側の受け皿も同じ情報に揃える
Googleの公式ガイドは、店舗のある事業者にはGoogleビジネスプロフィール、ECにはMerchant Center(商品情報をGoogleに登録する無料の管理画面)を整えることを勧めています。ChatGPTとは別の仕組みですが、サイトと同じ情報になっているかを一緒に確認します。
- 会社名・住所・料金・実績のズレは、AIの前に人を迷わせる
- 基準ページを1つ決め、他は合わせるかリンクにする
- Googleビジネスプロフィールと商品データも同じ情報に揃える
自社サイトのrobots.txtとインデックス状況を、一度見てほしい
そんなご相談から承っています。URLをお送りいただければ、検索用ボットの受け入れ、主要ページの検索登録、会社情報の食い違いを確認してお返しします。引用のお約束はしません。相談は無料です。
無料で相談する(develop-life.com/contact/)→ChatGPT引用のステップ5|料金・実績などの一次情報を自社サイトに置く
お客様がChatGPTに聞くのは「いくらか」「何ができるか」「頼んだ人はどうなったか」です。その答えが自社サイトに書かれていなければ、自社サイトから拾われることはありません。答えは別の場所から組み立てられます。
自社サイトに置いておきたい4つの一次情報
| 一次情報 | 載せる中身 |
|---|---|
| 料金 | 基本料金・追加料金・税込か税別か・改定日 |
| 仕様・サービス内容 | できること・できないこと・対応地域・納期 |
| 実績 | 業種・期間・数字(匿名で可) |
| よくある質問 | 問い合わせで実際に多い質問と答え |
「よくある質問」は、問い合わせで実際に聞かれた言葉をそのまま見出しにします。お客様がAIに打ち込む言葉と近くなるからです(私の考えで、OpenAIの公式基準ではありません)。文章の組み立てはAIに引用される記事の書き方で扱っています。
- 自社サイトに答えがなければ、自社サイトからは拾われない
- 料金・仕様・実績・よくある質問の4つを、自社サイトに置く
- 質問は、お客様が実際に使った言葉で見出しにする
ChatGPT引用のステップ6|ChatGPT経由の流入をGA4で分けて測る
OpenAIのFAQによると、ChatGPTから自社サイトへのリンクには「utm_source=chatgpt.com」という目印が付きます。utm_source(流入元を見分けるためにURLの末尾に付く目印)があるので、GA4(Google Analytics 4=サイトの訪問者やCVを解析する無料ツール)でChatGPT経由の訪問だけを分けて見られます。
GA4で見る手順
- GA4の「レポート」から「集客」→「トラフィック獲得」を開く
- 表の見出しを「セッションの参照元 / メディア」に切り替える
- 表の上の検索欄に「chatgpt」と入れて絞り込む
- 訪問数と、CV(コンバージョン=問い合わせ・購入などの目標達成数)を月ごとに記録する
Googleの数字と混ぜない
| 知りたいこと | 見る場所 |
|---|---|
| ChatGPTから何人来たか | GA4(utm_source=chatgpt.com で絞り込み) |
| Googleの生成AI機能でどれだけ表示されたか | Search Consoleの生成AIパフォーマンスレポート |
Search Consoleの生成AIレポートはGoogleの数字で、ChatGPTの数字ではありません。足し合わせないでください。有料ツールを検討するならLLMOツール比較2026を先にご覧ください。
月に数件でも、少ないまま記録します。増減は3か月分そろってから判断します。
- ChatGPTからのリンクにはutm_source=chatgpt.comが付く
- ChatGPTはGA4、GoogleはSearch Consoleの2本立て
- 少ない件数も少ないまま記録し、3か月で判断する
ChatGPT引用のステップ7|月1回の定点観測で回答を記録する
GA4で分かるのは「来た人の数」だけです。回答に自社がどう書かれているかは、自分で聞いて記録します。
聞き方を固定する3つのルール
- 質問文を一字一句固定する
- 質問は5〜10個に絞る(会社名で聞く質問と、会社名を入れずに探す質問を両方入れる)
- 毎月同じ時期に聞く(月初など)
回答は毎回同じとは限らないため、数か月分の傾向で見ます。
記録シートの見本
| 記録項目 | 書く内容の例 |
|---|---|
| 質問文(固定) | 「神戸で子ども向けのピアノ教室を探しています。どこがいいですか?」 |
| 自社名・リンクが出たか | 出た/出ない、出たURL |
| 一緒に出た競合・情報源 | 競合名、比較サイト名など |
| 内容の誤り | 古い料金、違う住所など |
役に立つのは「内容の誤り」の欄です。回答に古い料金が出ていたら、その料金が自社サイトのどこかに残っていないかをステップ4に戻って探します。
- 質問文・数・時期を固定して、月1回聞いて記録する
- 回答は毎回変わり得る。数か月分の傾向で見る
- 誤りを見つけたら、自社サイト側の古い記載を直す
ChatGPT引用でやってはいけない3つのこと
近道に見えて、私がおすすめしない3つです。根拠はGoogle’s Guide to Optimizing for Generative AI Features on Google Search(2026年7月10日更新・2026年10月31日取得)です。
1. 自社の名前を不自然に書いてもらう「言及集め」
Googleは「seeking inauthentic “mentions” across the web isn’t as helpful as it might seem」(Web上で不自然な言及を集めても、思うほど役に立たない)と書いています。紹介記事の量産や口コミの依頼は、割に合わないと私は考えます。
2. AI専用のファイルやマークアップを先に作る
Googleは「You don’t need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search.」と明言しています。llms.txt(AI向けにサイトの要約を書いたファイル)はGoogle検索では使われず、OpenAIにも引用されやすくなるという公式の記述は見当たりませんでした。ステップ1〜5が終わっていないなら、そちらが先です。
3. 実績を大きく見せる
実績の数字を盛るのは逆効果です。ページごとに数字が違えば、ステップ4の一貫性が崩れます。書いてある数字は、聞かれたら根拠を出せるものだけにしてください。
- 不自然な言及集めは、思うほど役に立たない(Google公式)
- AI専用ファイルは、ステップ1〜5より優先度が低い
- 実績は、根拠を出せる数字だけを1か所に書く
ChatGPT引用のよくある質問
Q. 設定を変えたら、いつ引用されますか
A. robots.txtの変更が反映されるまでは約24時間と公式ページにあります。ただしそれは「拾われる対象に入る」までで、引用の有無や時期は私にも約束できません。
Q. ChatGPTへの掲載を保証するサービスはありますか
A. 選定基準が公開されていない以上、保証の根拠を持つサービスはないと私は考えています。Googleも、第三者のツールは内部の仕組みにアクセスできないと書いています。「ChatGPTに出します」と約束する売り込みには注意してください。
- 反映は約24時間。引用の時期は誰にも約束できない
- 設定で変わるのは「拾われる対象に入るか」まで
- 掲載の保証をうたうサービスには、公式の根拠がない
用語集|この記事に出てきた言葉
- robots.txt
- 検索ボットに「どこを巡回してよいか」を伝える、サイトの入口に置くテキストファイル。
- OAI-SearchBot
- ChatGPTの検索機能でサイトを表示するためのOpenAIのクローラー。
- GPTBot
- 生成AIの基盤モデルの学習に使われ得る情報を集める、OpenAIのクローラー。
- UA(ユーザーエージェント)
- アクセス元が名乗るブラウザやボットの名前。
- WAF
- ウェブアプリケーションファイアウォール。不正なアクセスを自動で遮断する仕組み。
- インデックス/noindex
- インデックスは検索エンジンの索引への登録。noindexは「検索結果に載せないで」という指示。
- utm_source
- どこから来た訪問かを見分けるために、URLの末尾に付ける目印。
- GSC
- Google Search Console。検索結果での順位や流入を確認できる無料ツール。
- GA4
- Google Analytics 4の略。サイトの訪問者やCVを解析する無料ツール。
- CV
- コンバージョン。問い合わせ・購入などの目標達成数。
まとめ|ChatGPTの引用は保証できない。できるのは「拾える状態」づくり
サイト側でできることは、3つにまとまります。
- 入口を開ける:robots.txtとnoindexを確かめる(ステップ1〜3)
- 中身を揃えて置く:会社情報を揃え、一次情報を自社サイトに書く(ステップ4〜5)
- 測って直す:GA4と定点観測で誤りを見つけて直す(ステップ6〜7)
引用されるかどうかを決めるのはOpenAIで、基準は公開されていません。だから自社で確かめられる作業を全部終えてから、結果を待つ。これが私の原則です。外部に頼む場合の費用の目安はSEOコンサルティング費用・相場 2026、支援の進め方はSEOコンサル成功事例をご覧ください。
- まず入口(robots.txt・noindex)を確かめる
- 会社情報を揃え、一次情報を自社サイトに置く
- GA4と定点観測で測り、見つけた誤りを直す
ChatGPTに「拾える状態」になっているか、
一緒に確かめませんか
robots.txt、主要ページの検索登録、会社情報の食い違い、流入の測り方まで確認し、優先順位をお伝えします。ご案内するのは私のSEOコンサル(自社サービス)です。引用の保証はしませんが、判断の根拠は具体的にお伝えします。相談は無料です。
サイトの無料相談はこちら(develop-life.com/contact/)→関連記事